2026 年 9 月 1 日,李飞飞(Fei-Fei Li)联合创立的 World Labs 发布下一代世界模型 Atlas。官方给它的定位是 "omni world model for spatial intelligence"——一个统一处理文字、图像、相机位姿和 3D 深度图的全模态模型,既能从少数几张照片重建真实空间,也能按你设计的相机路径生成一段完整的、可自由漫游的视频世界。
一、Atlas 解决什么问题
World Labs 说的"世界模型",定义很直接:生成、重建、模拟任何一个可能的世界。
要干这件事,模型得理解一个世界长什么样、怎么运作、如何随时间演变。落到用途上有三个方向:
为创作者渲染想象出来的世界
高保真地模拟真实世界
帮助机器人规划动作
对应三种输出:生成、重建、仿真。Atlas 把它们放进了同一个模型。
二、能做什么:从相机控制到机器人仿真
相机可控生成(Camera-Controlled Generation)
Atlas 最主打的能力是像素级的相机控制。传统视频模型靠文字描述运镜("镜头缓慢左移"),Atlas 直接接收相机位姿作为原生输入——每个画面和深度图都绑定一个明确的相机姿态,空间控制被放到了架构中心。
官方这样形容这个体验:
你是在调度场景,不是在拉老虎机的拉杆。("you are staging the scene, not pulling the lever of a slot machine")
空间上下文:可以边生成边补图
Atlas 用空间上下文(Spatial Context)组织输入。给一张花园照片,它只还原花园,旁边的小屋和主宅靠"脑补";再补一张小屋实拍,输出里小屋准了,主宅还是想象;补上第三张主宅照片,整片场景才对上。
官方拿斯坦福主校区(Main Quad)举例:从草坪入口开始,一块一块补,最后到纪念教堂立面上一片彩色马赛克。这里只给了 2 到 25 张地面视角照片,Atlas 却能生成从校舍上空飞过的鸟瞰视角路径。
长视频与多路径重建
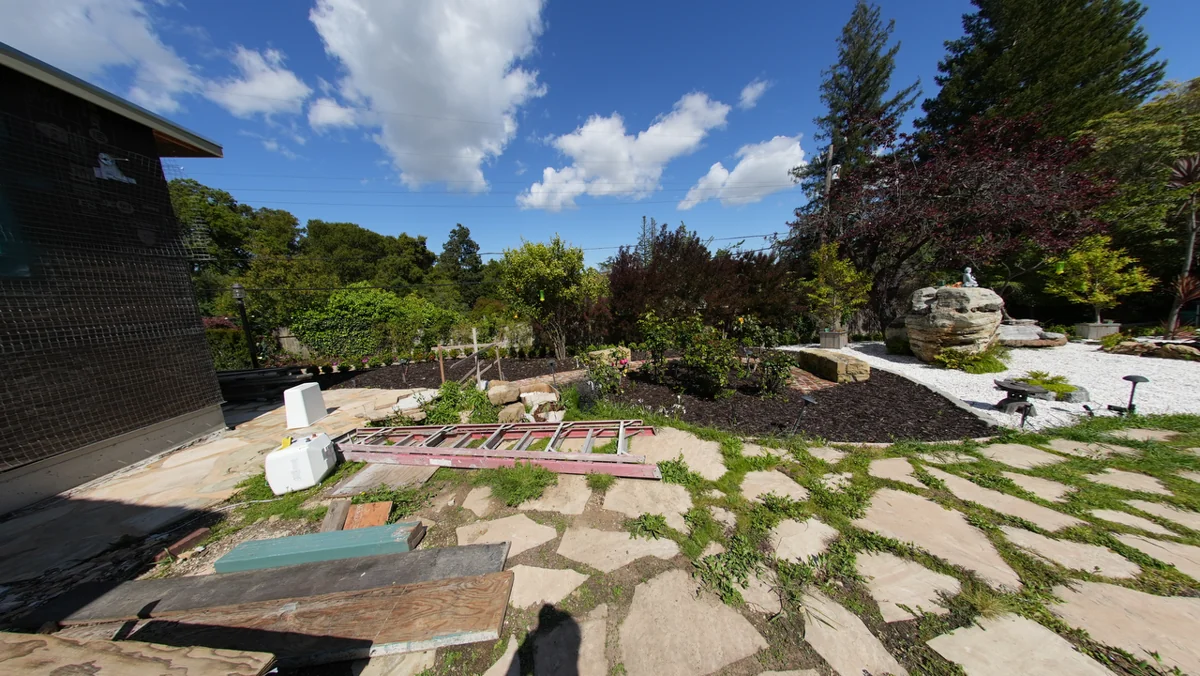
可控长视频:官方演示用少量参考图,手工设计相机路径,生成了一段 1440p 分辨率、时长 1 分钟的连贯世界视频。
多路径重建(Diverse Paths):同一组输入图,Atlas 能生成许多不同的相机轨迹,从不同角度重看同一场景;速度、长度、复杂度都可以变,场景始终保持一致。
空间重建:不需要专业设备
Atlas 能从一张或多张普通照片重建真实空间,不需要专门采集设备,也不需要几百张密集视角。官方把它看作稀疏视图新视角合成(novel view synthesis from sparse views)问题上的一步实打实的进展。
3D 输出、时空模拟与视频重取景
显式 3D 输出(Explicit 3D Outputs):直接产出深度等 3D 信息,而不只是平面图像。
时空模拟(Space-Time Simulation):用几台手机从不同角度拍摄,重建可任意重取景的时空场景。
视频重取景(Reframing Video):对已有视频做空间层面的重新构图。
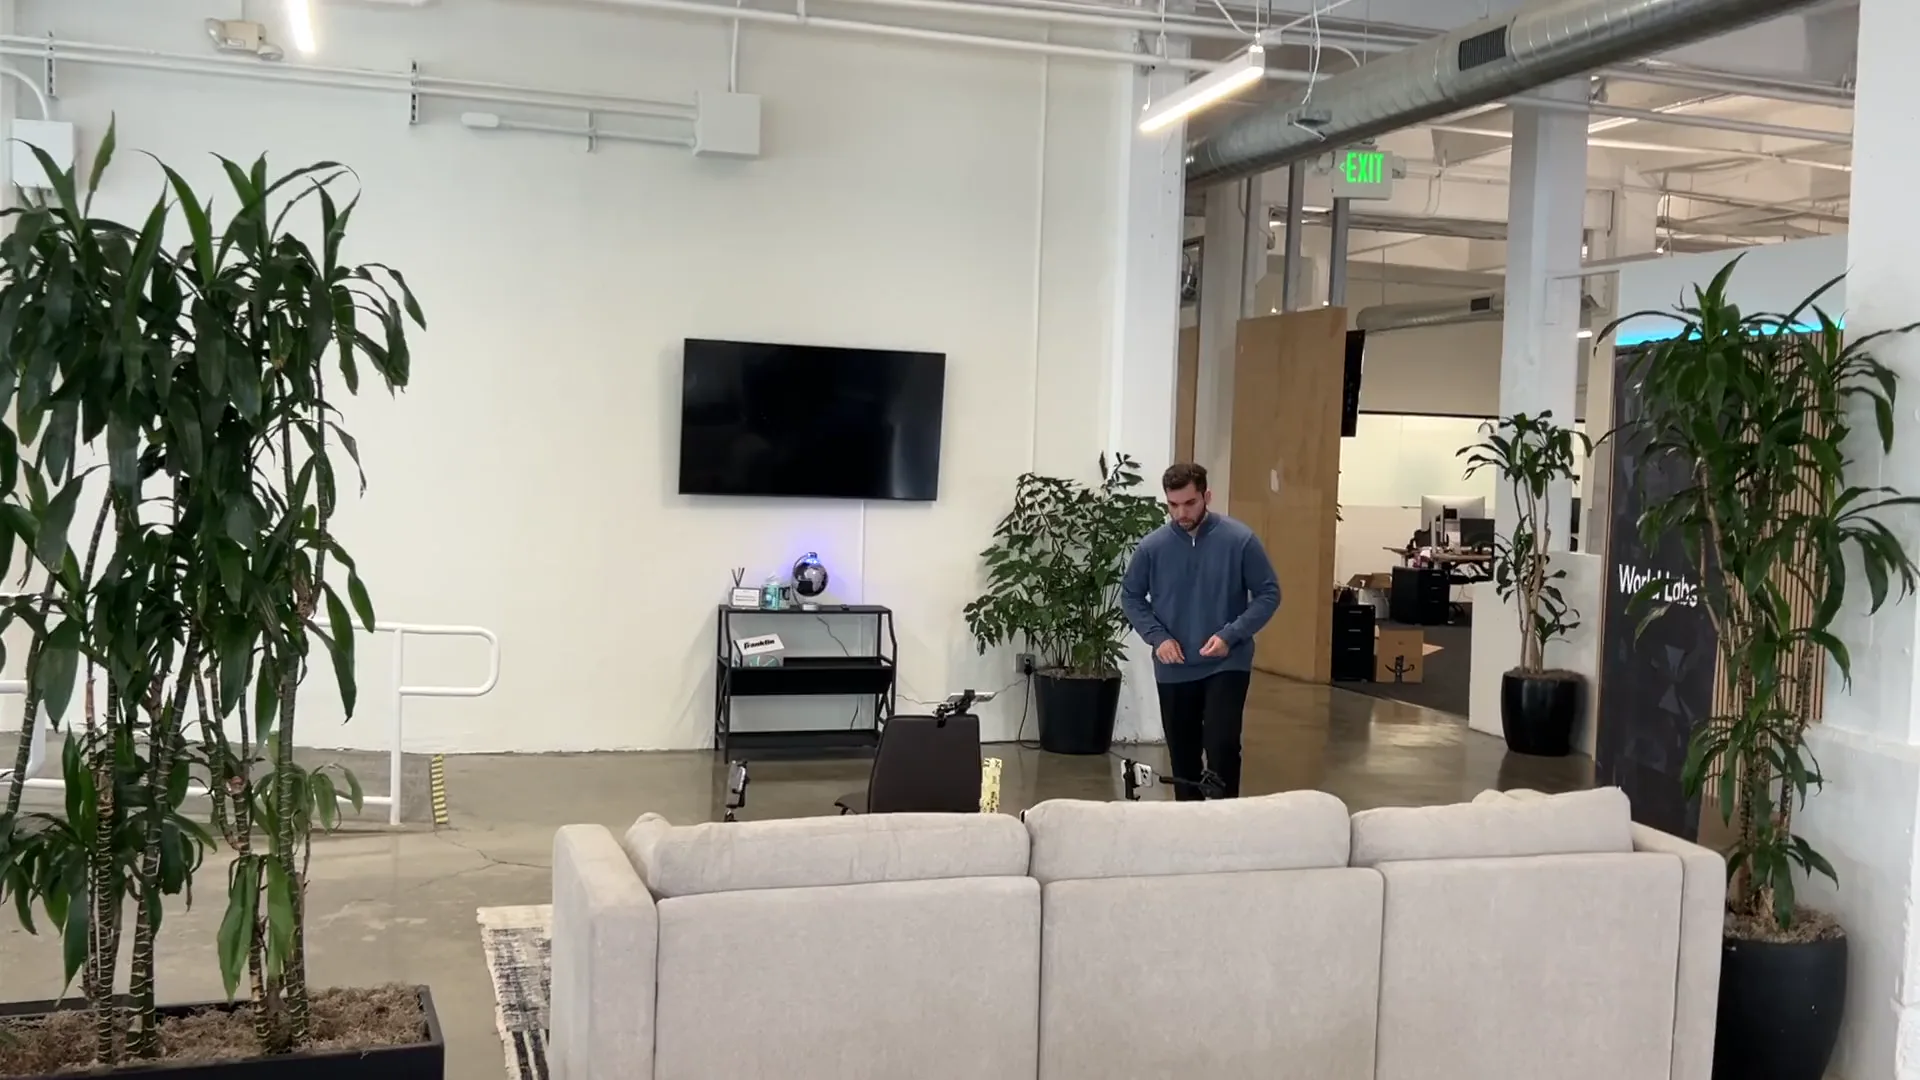
机器人仿真与图像生成
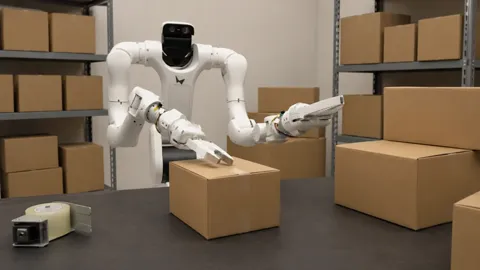
世界模型对机器人的价值:在高保真模拟环境里训练和评估策略,比在真实世界反复试错便宜得多。同月 World Labs 还发了"真实→仿真→真实"(Real-to-sim-to-real, R2S2R)的机器人训练方案。
另外 Atlas 也能做纯图像生成——它是一个称职的图像生成器,能跟随复杂提示词、渲染文字,并生成各种视觉风格。它还能由文本或图像提示直接生成 360° 全景图(等距柱状投影,equirectangular):
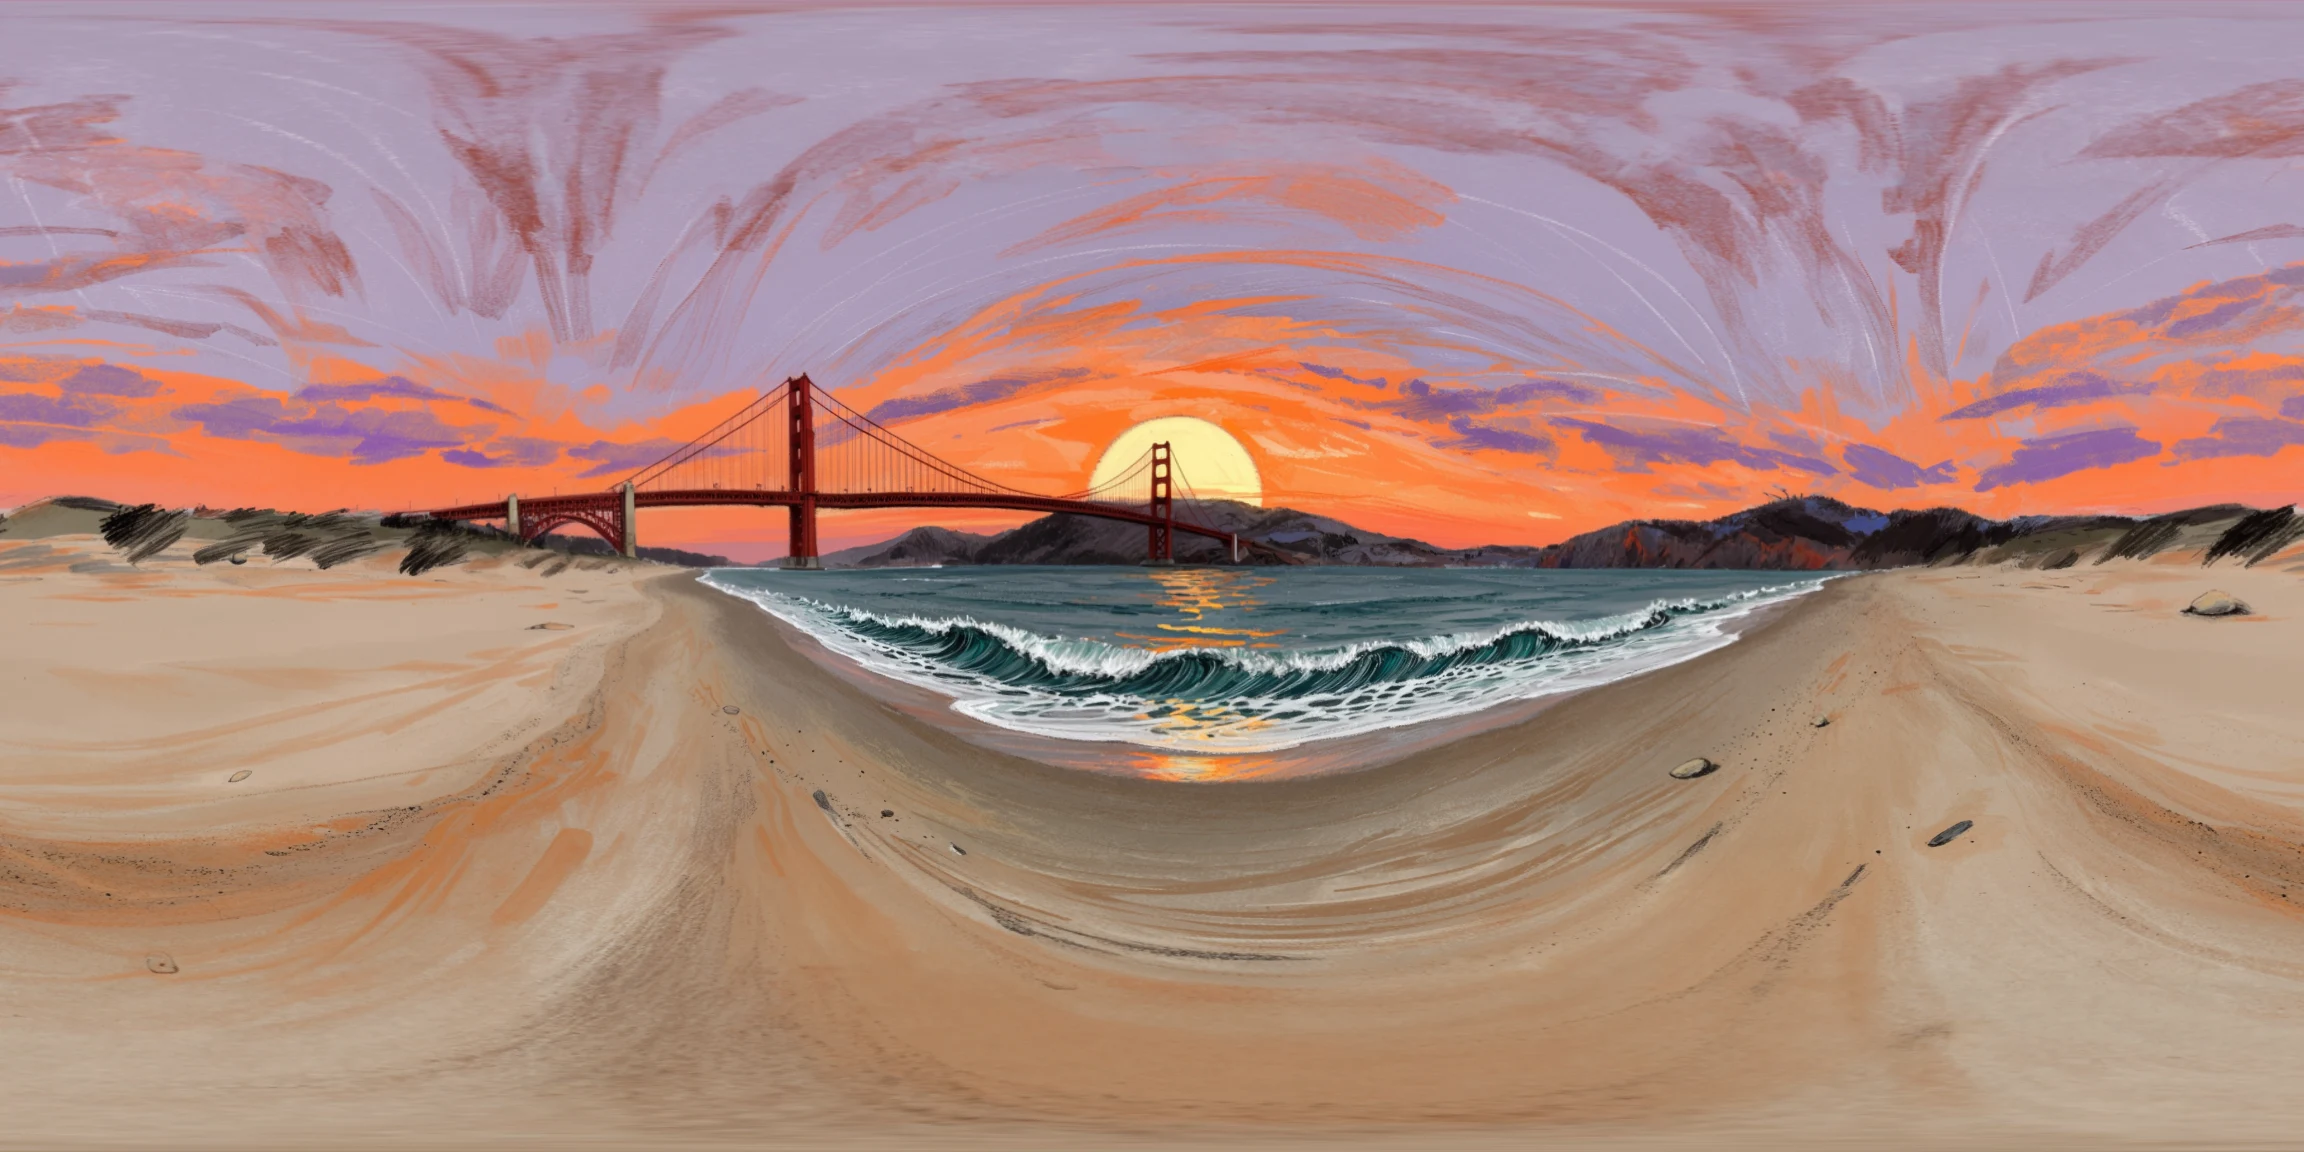
提示词:"on the beach in san francisco near the golden gate bridge at sunset, rough chalk drawing with think chunky strokes"
三、技术细节:一个"混血"架构
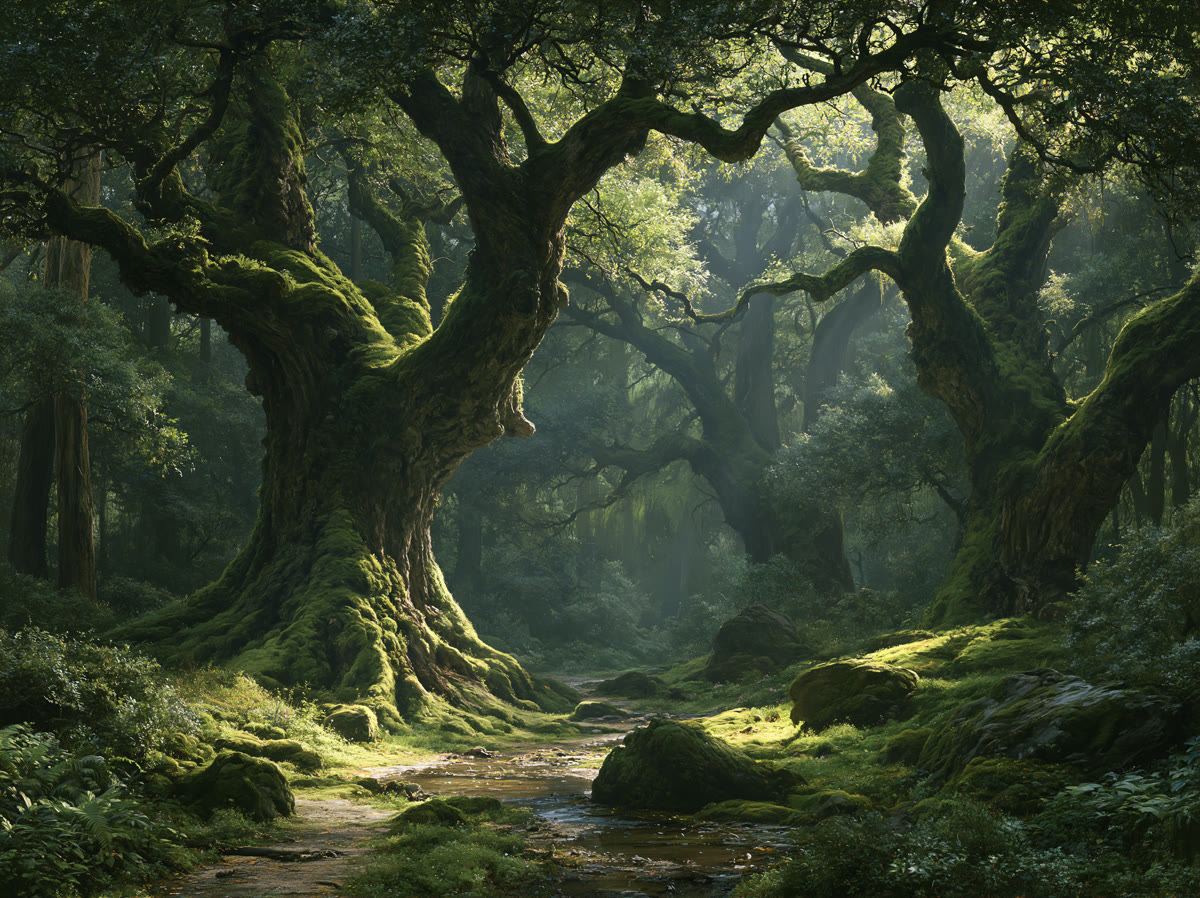
Atlas 的基座架构既没照搬 LLM,也没照搬视频模型,而是自己设计的一套多模态自回归扩散 Transformer(multimodal autoregressive diffusion transformer)。它的输入被锚定在 3D 空间里,形成"空间上下文";输出则在这个上下文条件下多模态生成。
四个关键词拆开看:
| 特性 | 含义 |
|---|---|
| Multimodal(多模态) | 原生处理文本、图像、相机位姿、3D 深度图;视频表示为图像序列。每个图像和深度图都绑定显式相机位姿 |
| Autoregressive(自回归) | 在序列上工作,每个元素逐次生成,条件依赖序列前面的部分。每类任务只是"不同种类的序列" |
| Diffusion(扩散) | 整流流(rectified flow)模型,逐步去噪生成输出;可通过去噪步数权衡速度与质量 |
| Transformer | 以大矩阵乘法为主,适配现代硬件,是世界建模的稳健骨干 |
有意思的是,Atlas 同时吃两边的红利:
像 LLM:作为自回归 Transformer,可以用 KV 缓存(KV-caching)、缓存感知路由、分离式服务(disaggregated serving) 等推理优化。
像现代图像/视频模型:作为潜在扩散模型(latent diffusion),可以用 扩散蒸馏、无分类器引导(classifier-free guidance)、移位噪声调度、VAE 设计 等算法。
四、跑分:通用模型打赢专用模型
Atlas 是全能选手,官方也承认没有任何单一基准能完整衡量它的通用性,所以挑了两个关键任务做定量评测:相机条件生成和 3D 重建。测试结果:两项都超过了对应的专用模型。
相机条件生成
每个测试给一个输入图 + 一到三种电影运镜(平移 pan、横移 truck、升降 crane 等)。Atlas 用原生相机格式编码路径;其他模型不接受相机原生输入,只能用文字描述运镜(标准电影术语,这已是最常见的输入形式)。
由第三方人类评审盲选哪个模型更贴合指定相机路径。结果(选择 Atlas 的投票占比):
| 对比模型 | 选择 Atlas 的比例 |
|---|---|
| MiniMax H3 | 75% |
| Gemini Omni Flash | 81% |
| Happy Horse 1.1 | 86% |
| FLUX 3 | 93% |
| Seedance 2.5 | 94% |
相机轨迹越复杂,Atlas 的优势越明显。
3D 重建:稀疏视图
给定一组图 + 相机位姿,预测每个输入像素对应的 3D 点。Atlas 作为通用模型,在多个基准上超过了最好的开源专用重建模型。下面是重建误差越低越好(AbsRel ×10⁻³):
| Benchmark | Atlas(Ours) | Pi3X (posed) | π³ | VGGT-Ω 1B | Depth Anything 3 | MapAnything |
|---|---|---|---|---|---|---|
| Average | 25.3 | 28.7 | 34.7 | 36.4 | 39.3 | 47.7 |
| DTU | 8.6 | 11.1 | 16.2 | 9.7 | 11.9 | 18.2 |
| ETH3D | 9.3 | 18.7 | 25.4 | 11.4 | 23.8 | 34.8 |
| KITTI | 60.0 | 60.2 | 74.8 | 101.4 | 93.3 | 115.3 |
| NRGBD | 6.5 | 13.3 | 17.5 | 10.5 | 11.3 | 20.2 |
| 7-Scenes | 37.8 | 39.3 | 44.4 | 45.2 | 50.8 | 47.4 |
| T&T | 42.4 | 42.4 | 47.0 | 40.2 | 55.1 | 60.8 |
| ScanNet | 12.4 | 15.7 | 17.4 | 36.6 | 29.0 | 37.0 |
五、模型扩展性
现代 AI 的进步大多来自扩展(scaling)。World Labs 从零在大规模多模态数据上预训练 Atlas,开发期间训练了一系列规模与算力递增的模型,每一次算力提升都解锁了新能力。官方表示,未来的世界模型会沿这条曲线继续往上走。
六、怎么用:早期访问
Atlas 目前处于早期访问(early access)阶段,仅面向精选合作伙伴开放。
想接入的话,可以在官方页面申请早期访问权限,团队会联系你。
World Labs 同时在招聘研究与工程岗,推进空间智能。
官方入口一览(均可在浏览器直接打开):
| 用途 | 链接 |
|---|---|
| Atlas 官方发布页 | https://www.worldlabs.ai/blog/atlas |
| World Labs 官网 | https://www.worldlabs.ai/ |
| 关于 World Labs | https://www.worldlabs.ai/about |
| 研究动态(Research & Insights) | https://www.worldlabs.ai/blog |
| Marble Labs(上手体验) | https://www.worldlabs.ai/labs |
| 社区案例(Community Showcase) | https://www.worldlabs.ai/labs/showcase |
| 学习中心 | https://www.worldlabs.ai/labs/learn |
| 开发者平台 / API | https://platform.worldlabs.ai/ |
| Spark(3DGS 渲染库) | https://sparkjs.dev/ |
| 用 Marble 创作 | https://marble.worldlabs.ai/ |
| 机器人训练方案 R2S2R | https://www.worldlabs.ai/blog/real-to-sim-to-real |
引用信息(BibTeX):
@article{worldlabs2026atlas,
    author = {World Labs Team},
    title = {Atlas: A World Model for Spatial Intelligence},
    journal = {World Labs Blog},
    year = {2026},
    note = {https://www.worldlabs.ai/blog/atlas},
}
延伸阅读(World Labs 官方相关文章):
《The Next Frontier of AI Is Spatial Intelligence》——a16z 的 Martin Casado 与李飞飞、Yunzhu Li 对谈:聊 SceniX 收购、模拟如何解锁下一代机器人,以及为什么训练机器人和训练大语言模型是两回事。
《Building Worlds That Train Robots》——真实→仿真→真实(R2S2R)作为可扩展的机器人策略训练与评估引擎。
七、几点值得注意
"世界模型"不等于"视频生成"换个说法。Atlas 把相机位姿当原生输入,输出的是一致的三维空间,不是一段看着对、空间却前后打架的像素流。
通用模型打赢了专用模型。3D 重建和相机控制两条线上,Atlas 都压过了专门做这件事的模型。这跟"全能等于样样稀松"的直觉反着来。
李飞飞的空间智能路线在拼图。从早年 ImageNet 到 World Labs,把"让 AI 理解三维世界"一点点做成能落地的模型和产品线:Atlas + Marble + Spark + R2S2R。
别只看演示。视频里一分钟 1440p 的连贯漫游确实好看,但官方也说明页面上其他视频为性能做过压缩;真实可用性要等早期访问开放后才能验证。
素材授权与来源
原文来源:World Labs 官方博客《Atlas: A World Model for Spatial Intelligence》
发布时间:2026 年 9 月 1 日
作者:World Labs Team
图片:均下载自 World Labs 官方网站(wlt-ai-cdn.art CDN)用于本文介绍与展示,版权归 World Labs 所有。本文为转载介绍性质,不主张对原图的所有权。
免责:本文技术细节与数据均引自官方发布内容;解读部分为编者补充,若有出入以官方原文为准。
版权声明
本文仅代表作者观点,不代表本网站立场。
本文系作者授权本网站发表,未经许可,不得转载。


发表评论