本文整理自 formiat 于 2025 年 9 月在 Open Robotics 官方社区(Discourse)发布的帖子,介绍其开源项目
formiat/px4-ros2-drone-nav(release v0.2.1)。
这是什么
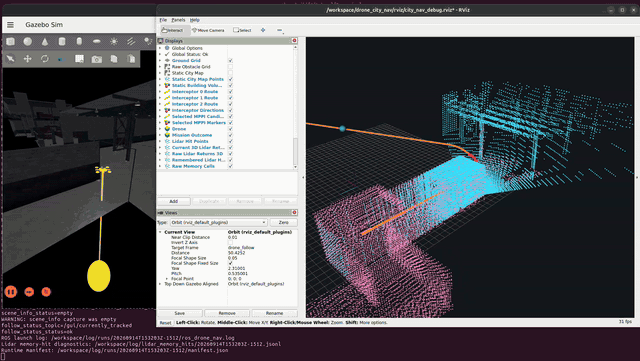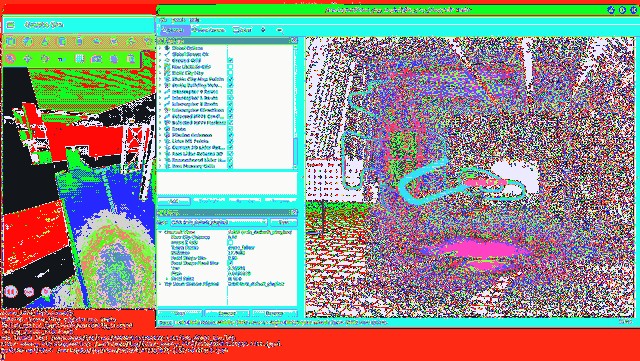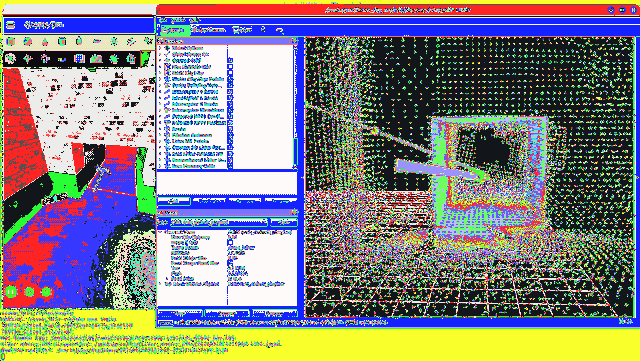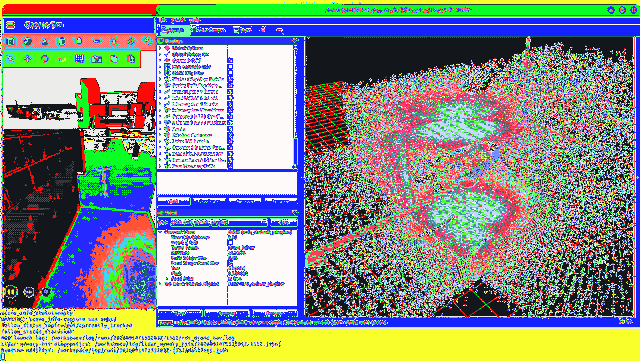
一套给四旋翼用的开源导航栈。给它一个起点、一个终点,扔进多层城市楼宇世界里——没有地图。它靠机载的仿真 3D 激光边飞边建自己的障碍物记忆,在这份记忆上做完整的 3D 规划,最后通过 PX4 的 offboard 模式执行。
协议:MIT
定位:仿真优先,明确声明未在真机验证
仓库:https://github.com/formiat/px4-ros2-drone-nav(release v0.2.1)
完整飞行演示(约 3 分钟):https://www.youtube.com/watch?v=rKXcERqb9Ho
场地:DARPA Subterranean Challenge "Urban Circuit Practice 01" 世界,由 Open Robotics 发布在 Gazebo Fuel(CC BY 4.0),连同碰撞几何一起导入
技术栈
运行环境为 ROS 2 Jazzy + PX4 SITL v1.17(走 uXRCE-DDS)+ Gazebo Harmonic + CUDA(供优化器使用)。代码是一个 ament 包 drone_city_nav,外加 Gazebo 资产、PX4 编排脚本和容器工具链。
数据流如下:
Gazebo GPU 激光(360 x 181 束,10 Hz)+ PX4 本地位置
  -> obstacle_memory_3d_node:按时间戳对齐的射线积分,写入
     可版本化的 unknown/free/occupied Occupancy3D,
     基快照(base snapshot)+ 脏块(dirty chunks)
  -> production_mppi_node
       自适应 26 连通 3D 栅格上的持久化稀疏 D* Lite
       -> 带速度剖面的认证路线几何
       -> 50 Hz 的 CUDA MPPI 局部视界
       -> 对原始占据栅格做精确扫掠足迹(swept-footprint)校验
       -> 原子执行计划 -> 带时间戳的 MppiTrajectoryHorizon
  -> mppi_offboard_node -> PX4 轨迹设定点
Gazebo 的接触事件走一条独立通路:无人机一旦发生接触,会触发 collision_crash_node,它发布一个带类型的销毁事件,并把 offboard 锁进 disarm 生命周期。崩溃由任务校验检出,不靠轨迹反推。
核心争议点:把未知空间当作可通行
这套栈里,Free 和 Unknown 的可通行性完全相同、基础代价也完全相同。只有两类硬约束:已确认的 Occupied 栅格,以及飞行器实际扫掠出的物理外壳。没有"必须已知"开关,没有边界停等策略,没有膨胀,也不偏向于飞过已经看过的地方。规划器会直接承诺一条穿过没人看过区域的路线。
保证安全靠的是一个不等式,它被当作速度律应用到所有地方:
speed * total_latency + stopping_distance + physical_margin
    <= guaranteed_lidar_detection_range
总延迟 = 配置的时间戳对齐激光证据最大年龄 + 控制反应延迟
停止距离 = 由 jerk 受限模型给出,取水平与垂直保证减速度中较弱的一个
保证探测距离 = 通过配置测试,绑定到传感器模型和障碍物记忆自身的量程
代入一组参数:14 m 保证探测距离、0.6 s 证据年龄、0.1 s 反应时间、2 m 物理余量,这个契约在平飞时允许约 5.6 m/s。飞行器始终按"能在传感器保证分辨的范围内停住"这个速度飞,所以进入未观测空间是有界的风险,不是盲赌。
代价体现在下面的路线可用率上:当前方几米处真的冒出一堵墙,路线被判无效,重新搜索需要时间,这期间飞行器只能刹车。
验证过的飞行
命令 make sim-urban-point-to-point-headless,在同一个 commit 上连飞五次,中间不做任何改动(release 系列,已在 CHANGELOG.md 复现):
| 飞行 | 路径长度 | 时长 | 平均速度 | 碰撞 | 路线可用率 | 规划器 p95 |
|---|---|---|---|---|---|---|
| r288 | 399.9 m | 137.8 s | 2.90 m/s | 无 | 95.1 % | 154 ms |
| r289 | 384.6 m | 148.8 s | 2.58 m/s | 无 | 93.1 % | 152 ms |
| r290 | 401.5 m | 134.4 s | 2.99 m/s | 无 | 92.0 % | 157 ms |
| r291 | 371.5 m | 123.9 s | 3.00 m/s | 无 | 91.2 % | 154 ms |
| r292 | 417.2 m | 134.7 s | 3.10 m/s | 无 | 88.9 % | 155 ms |
平均速度 = 路径长度 / 从任务就绪到成功完成的时间,所以每一次悬停、停顿和重规划都会被算进去。路线可用率 = 全程中"持有通往终点的认证路线"的时间占比。工作站为 16 线程 + RTX 3060。
回归测试的是假设,不只是结果
作者说,这部分他建议所有在仿真里做 offboard 控制的人都看看:每次无头飞行都会记录轨迹设定点、PX4 的本地位置和 Gazebo 真值位姿,任务校验随后拿四项测量去对撞导航律所依赖的假设:
p99 横向跟踪误差
机体在制动下降时实际给出的减速度
位姿估计对真值(时钟按速度剖面对齐)
规划时刻激光证据的年龄
好处在于:一条悄悄失效的法则会在下一次飞行就挂掉检查,不必等三周后靠一次坠机才发现。
那个闭环里跑出的两个发现:
下降制动假设错了。 停止律原本假设 3 m/s² 的下降制动减速度。用 PX4 本地位置实测,x500 的实际下降制动是 1.4 到 2.2 m/s²,原因是制动下降受限于悬停以上的推力而非
MPC_ACC_UP_MAX。有一次飞行直接扎到了激光已在下方 2.3 m 处分辨出的屋顶上。PX4 的
EKF2_GPS_DELAY默认 110 ms,对真实接收机是对的。但 Gazebo 桥在收到仿真 navsat 采样时才打时间戳,滤波器于是减掉了一个根本不存在的延迟,把飞行器放到了它"本该已经移动到"的位置:位置估计沿运动方向比真值超前 0.11 s,3 m/s 时相当于 0.35 m。在 SITL 里把它设为 0,这个超前就消失了,p99 横向跟踪误差从 0.13–0.29 m 降到 0.03–0.18 m。如果你在 Gazebo 里飞 offboard 并且觉得飞行器在切内弯,这一条值得查。
怎么跑起来
在装有 Docker 和 NVIDIA 容器运行时的 Linux 主机上,一条脚本就能准备好全新克隆(dev 镜像、PX4 SITL 构建、工作空间、带版本的环境资产)并启动飞行:
git clone https://github.com/formiat/px4-ros2-drone-nav.git
cd px4-ros2-drone-nav
./scripts/bootstrap.sh
--headless:不带 GUI 跑同一次飞行,并带任务校验--no-run:只做准备、不启动每一步只要结果已存在就会跳过。首次运行要下载数 GB 内容并构建几十分钟。
局限
作者列出的边界:
路线可用率 88.9–95.1%,任务校验想要 97%;差的那部分,就是未观测空间里突然冒出墙之后重新搜索所花的时间。
定位用的是 PX4 的 EKF,全程距真值 0.19–0.25 m,障碍物记忆建立于观测时刻的估计坐标系。目前还没有机制把估计对齐到地图;无 GNSS、无磁力计的激光-惯性定位是下一个里程碑。
参数都针对这套仿真调过:x500 机体、PX4 SITL v1.17、Gazebo Harmonic、ROS 2 Jazzy。仓库里有多机协同交通与拦截场景,但最后一次飞行还在 9 月导航改动之前。
这是面向仿真的研究代码。 没有独立安全评审和失效保护设计,别装到真机上。
向社区提出的三个问题
你如何决定"以多快飞进还没观测过的空间"?作者用的是保证探测距离 + 证据年龄预算;想听听其他形式,尤其是能扛住带盲锥传感器的方案。
用
nav2_mppi_controller的人:这里的局部优化器是独立的 CUDA 实现,带 3D 路线和更新后的原始扫掠足迹校验。有人在空中平台上跑 Nav2 的 MPPI 做完整 3D 吗?它从哪一步开始不再合适?除了"任务完成了",你在控制器侧跨运行回归测试哪些东西?
相关链接
开源仓库:https://github.com/formiat/px4-ros2-drone-nav(MIT,release v0.2.1)
完整飞行视频(约 3 分钟):https://www.youtube.com/watch?v=rKXcERqb9Ho
Gazebo Fuel 世界:DARPA Subterranean "Urban Circuit Practice 01"(CC BY 4.0)
原文来源:Open Robotics 官方社区 Discourse,作者 formiat
说明:项目为 MIT 协议的开源仿真研究代码,作者明确声明未在真机验证。
版权声明
本文仅代表作者观点,不代表本网站立场。
本文系作者授权本网站发表,未经许可,不得转载。


发表评论